アラートルール
「アラート管理 → アラートルール」で GUI を使って設定します。一般的なシナリオでは PromQL の記述は不要ですが、カスタム式にも対応しています。
警告
閾値と通知ポリシーの設定は運用担当者が行ってください。不適切な設定は誤検知や検知漏れにつながるため、本番適用前にテスト環境で検証することを推奨します。
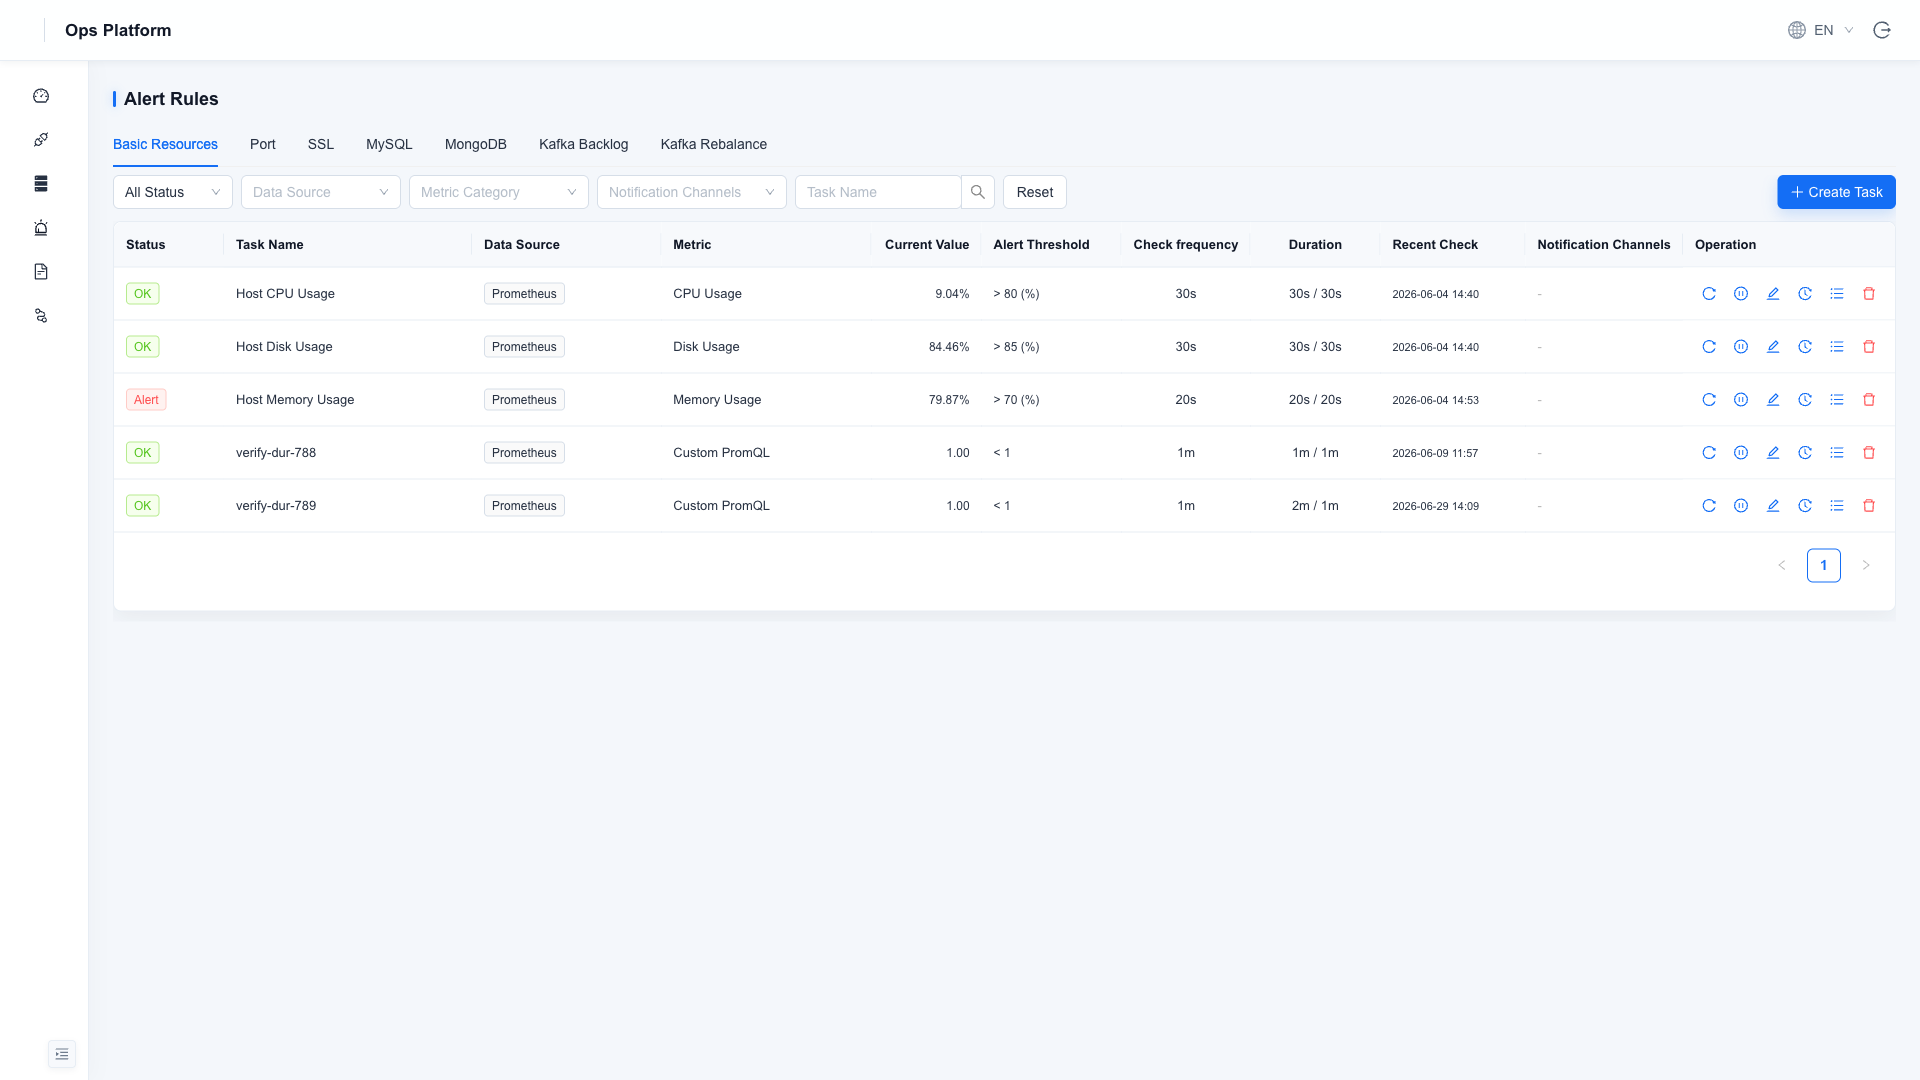
監視タイプ
ルールページはタイプ別のタブに分かれています。ミドルウェアのタブは、対応するデータソースを有効にした場合のみ表示されます:
| タブ | 監視内容 | 表示条件 |
|---|---|---|
| 基本リソース | ホスト/ミドルウェアの CPU、メモリ、ディスクなど。カスタム PromQL に対応 | 常時 |
| ポート | TCP ポートの接続確認 | 常時 |
| SSL | HTTPS 証明書の有効期限 | 常時 |
| MySQL | 接続数/スロークエリなど | MySQL データソースを有効化 |
| MongoDB | 接続数/レプリケーション遅延など | MongoDB データソースを有効化 |
| Kafka 滞留 | コンシューマーグループの Lag | Kafka データソースを有効化 |
| Kafka リバランス | コンシューマーグループの頻繁なリバランス | Kafka データソースを有効化 |
ルールの作成
「新規タスク」をクリックし、案内に従って入力します:
| フィールド | 説明 |
|---|---|
| タスク名 | 一意で分かりやすい名前(例:本番ホストの CPU 使用率が高い) |
| データソース | 監視対象インスタンス |
| 指標 | 組み込み指標を選択、または「カスタム PromQL」で式を直接入力(結果をプレビュー可能) |
| アラート閾値 | 演算子 + 閾値(例:> 80) |
| チェック頻度 | チェックする間隔 |
| 継続時間 | アラートになるまで連続して閾値を超える時間。一時的な変動を除外 |
| 通知チャンネル | 通知チャンネルを関連付け。未指定の場合は運用プラットフォーム内への記録のみ |
状態遷移
ノイズを抑える状態管理機構を内蔵し、状態が変化したときのみ通知します。同一アラートが継続しても通知を繰り返しません:
正常 ──閾値超過──▶ 予兆(Pending) ──継続時間を満たす──▶ アラート(Firing) ──復旧──▶ 復旧(Recovered)
| 状態 | 意味 |
|---|---|
| 予兆 Pending | 閾値超過、継続時間は未達 |
| アラート Firing | 閾値超過かつ継続時間を満たし、通知済み |
| 復旧 Recovered | アラートから正常に復旧し、復旧通知を送信 |
| 一時停止 | ルールを手動停止し、スケジュール実行を停止 |
よく使う操作
- 今すぐチェック:待機をスキップして即時実行します。
- 一時停止/有効化:計画メンテナンス時に一時的にスケジュール実行を停止します(旧版の「アラートのサイレンス」を置き換えます)。
- インスタンス詳細:ルールに一致する各インスタンスの現在値を確認します。インスタンス単位のサイレンスに対応し、個別インスタンスのみを抑制しながらルール全体は実行を継続します。
- アラート履歴:このルールの発生記録を確認します。全体表示はアラート履歴を参照してください。