概述
运维平台用于监控和诊断 HAP/HDP 私有部署环境。平台汇集主机、中间件和 Kubernetes 集群的监控信息,提供日志查询、链路追踪、慢查询分析和告警功能,供运维人员查看运行状态和排查问题。
部署完成后,可在数据源管理中添加需要监控的主机和中间件,并根据实际环境接入服务日志和链路追踪。
功能一览

| 模块 | 能力 | 文档 |
|---|---|---|
| 概览 | 系统健康度、监控任务统计、活跃告警与近 24 小时告警动态 | 本页 |
| 资源监控 | 查看主机、中间件和 Kubernetes 集群的监控信息,支持通过自定义页面嵌入 Flink 等外部页面 | 资源监控 |
| 告警 | 配置监控规则和通知渠道,查看告警状态、恢复情况及历史记录 | 告警规则 |
| 日志 | 查询容器日志和 HAP/HDP 微服务的服务日志,支持按时间和关键字检索 | 日志查询 |
| 链路追踪 | 查看请求在微服务间的调用路径和耗时,适用于 Kubernetes 环境 | 链路追踪 |
| 慢查询诊断 | 分析 MongoDB 慢查询,查看查询详情和索引优化建议 | MongoDB 慢查询分析 |
运维平台部署在被监控的 Kubernetes 集群内时,可自动采集该集群的指标。监控其他集群时,需在目标集群内部署采集组件,详见 Kubernetes 集群监控。
技术架构
运维平台通过 Prometheus、Grafana、Loki、Tempo 和 Grafana Alloy 采集、存储及展示监控数据:
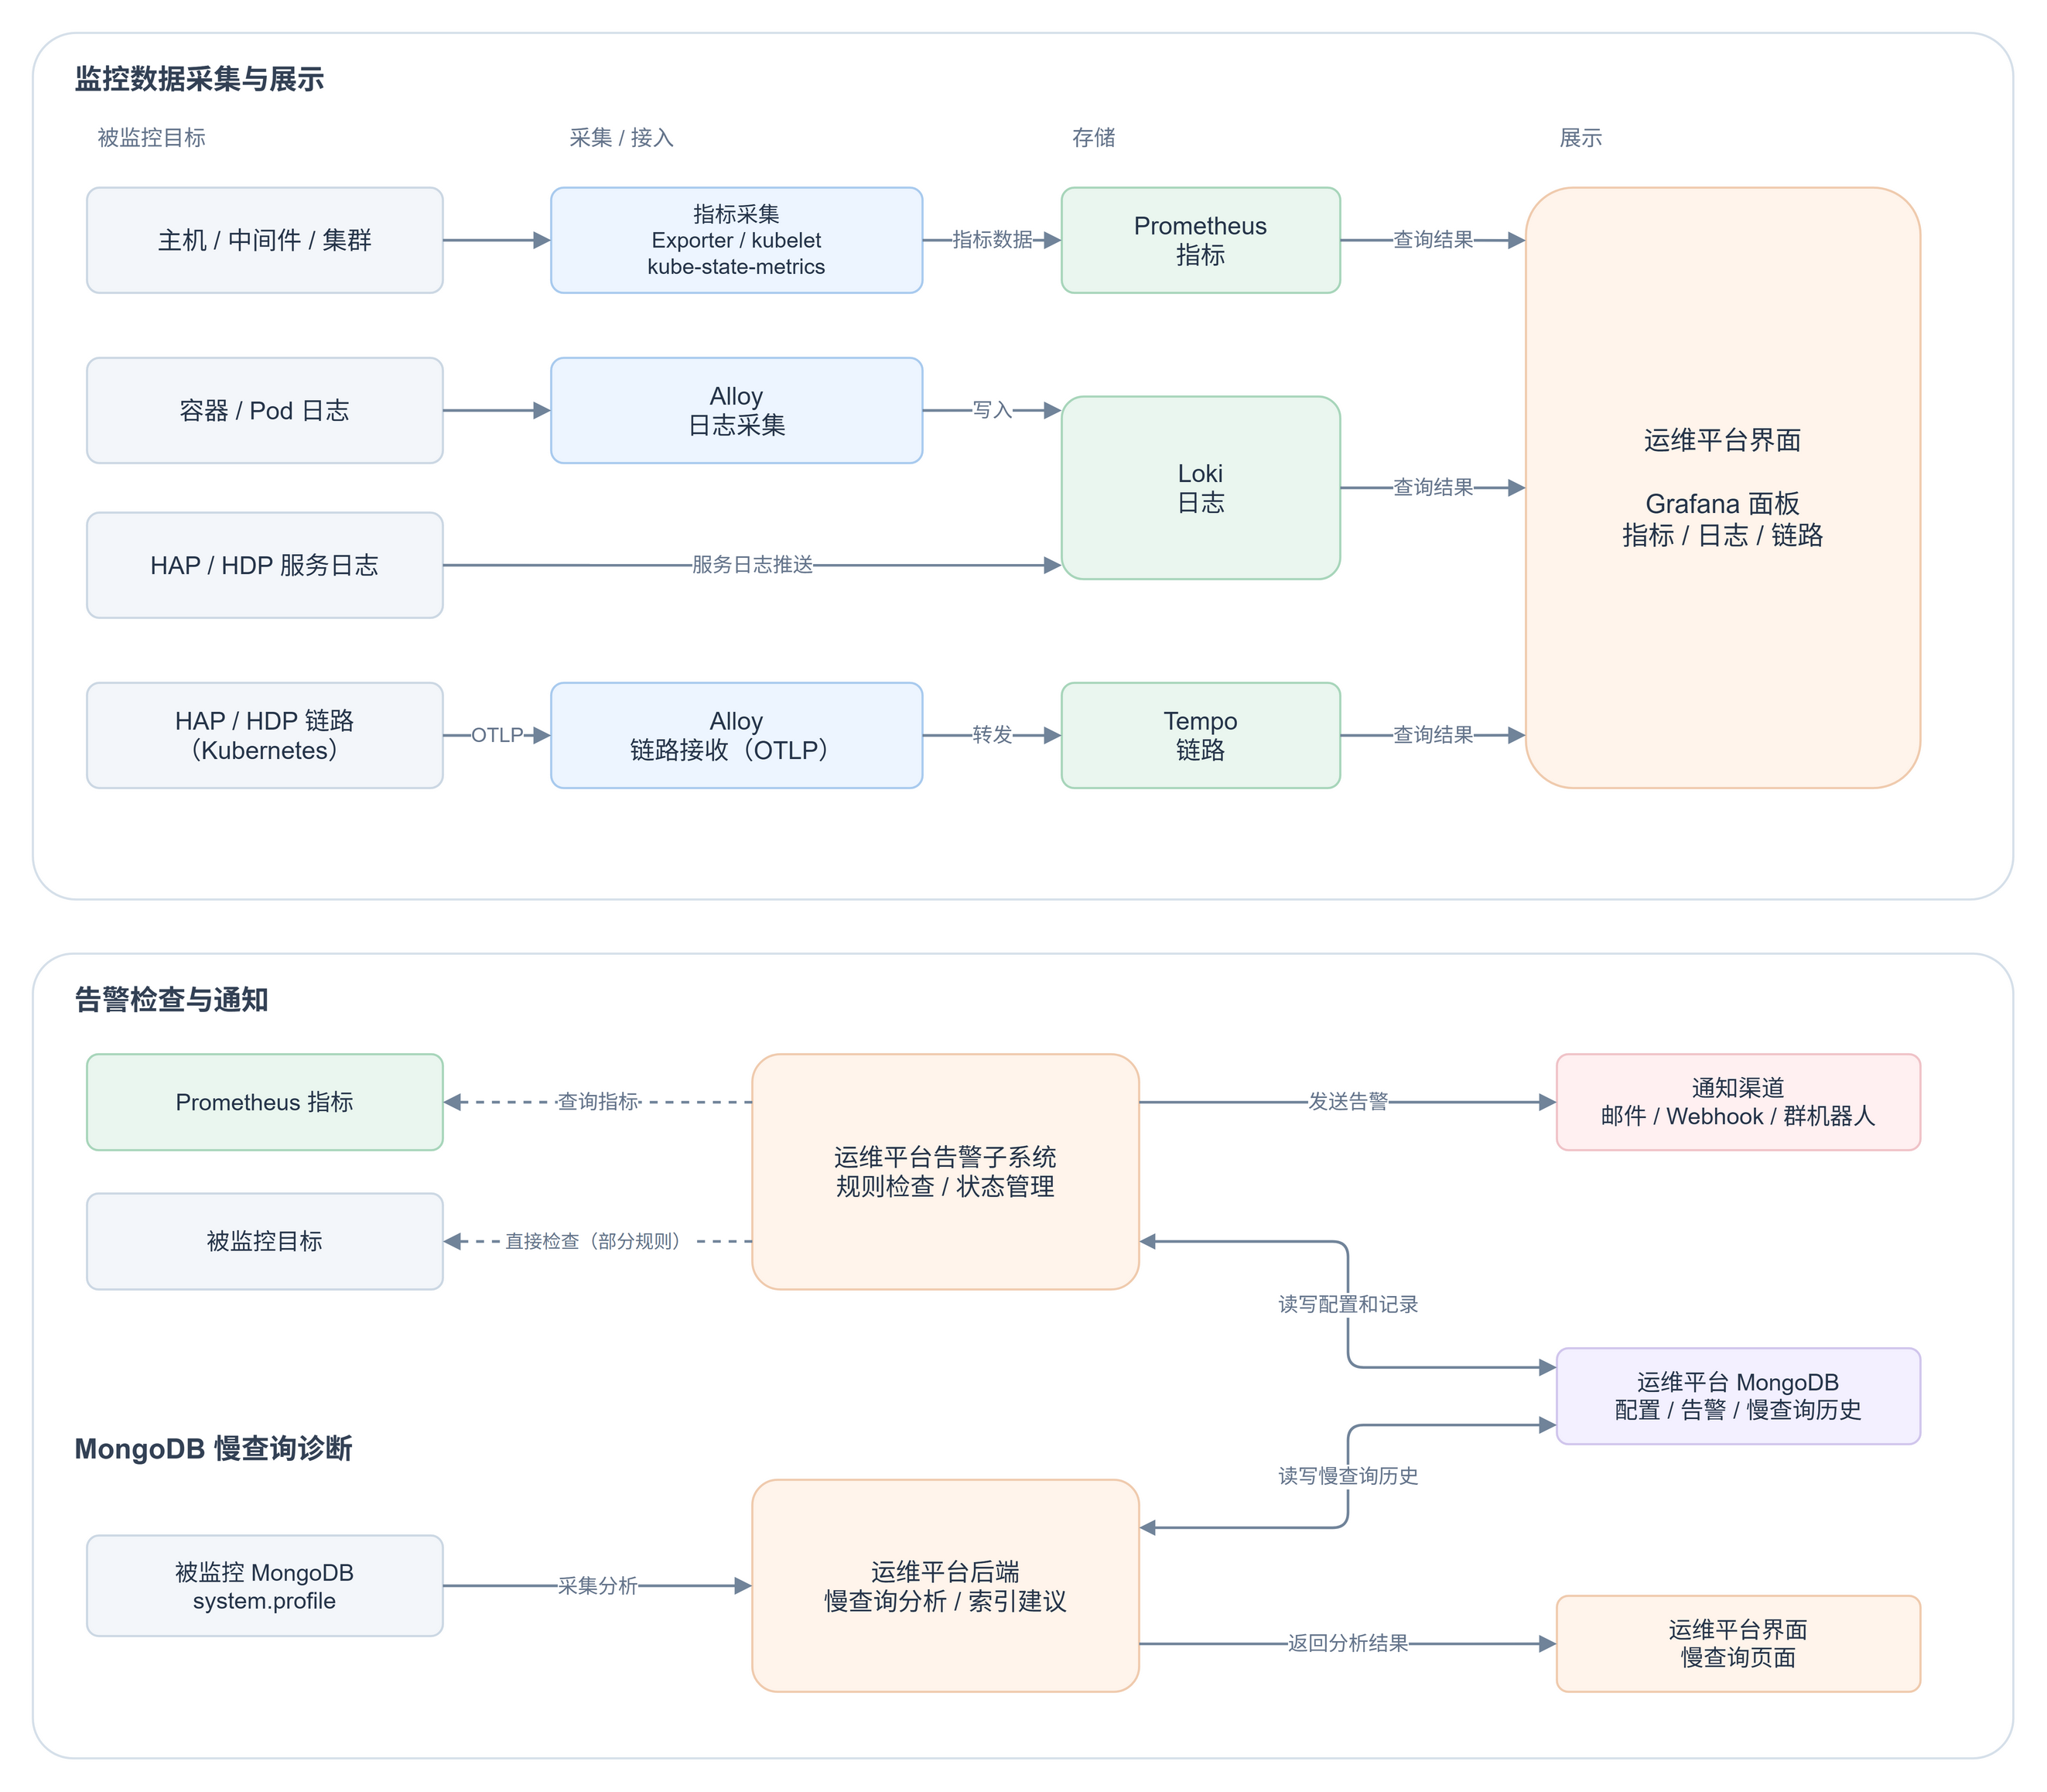
- 指标:Prometheus 采集并存储主机、中间件及 Kubernetes 集群指标,Grafana 提供监控面板。
- 日志:Alloy 采集容器日志,HAP/HDP 服务日志由微服务推送至 Loki。服务日志需要在产品服务侧配置接入,详见服务日志。
- 链路:应用通过 OTLP 将链路数据上报至 Alloy,再转发至 Tempo 存储,由 Grafana 展示。
- 告警:运维平台根据规则查询指标或检查监控目标,并通过通知渠道发送告警。
- 慢查询:运维平台采集 MongoDB 慢查询记录,分析查询情况并提供索引建议。
告警规则、状态、历史记录及慢查询历史等数据存储在运维平台自有的 MongoDB 中,与被监控的业务数据库分开。
组件版本
运维平台使用的组件及版本如下:
| 组件 | 版本 | 作用 |
|---|---|---|
| Prometheus | 3.1.0 | 指标采集与存储 |
| Grafana | 12.2.1 | 统一可视化界面 |
| Loki | 3.5.8 | 日志聚合与检索 |
| Tempo | 2.9.0 | 分布式链路存储 |
| Grafana Alloy | 1.11.3 | 统一可观测性采集(容器日志/OTLP) |
| Node Exporter | 1.8.2 | 主机资源指标 |
| kube-state-metrics | 2.10.1 | Kubernetes 集群对象状态 |
| Kafka Exporter | 1.6.0 | Kafka 指标采集 |
| Elasticsearch Exporter | 1.5.0 | Elasticsearch 指标采集 |
| Redis Exporter | 1.44.0 | Redis 指标采集 |
| MySQL Server Exporter | 0.15.1 | MySQL 指标采集 |
| MongoDB Exporter | 0.42.0 | MongoDB 指标采集 |
| MongoDB | 4.4.28 | 告警子系统自有存储(与被监控目标解耦) |